HSTUとGenerative Recommenders――行動履歴から1.5兆parameterの推薦モデルへ
MetaのHSTU論文を、推薦のsequential transduction化、pointwise attention、Stochastic Length、M-FALCON、公開実験とproduction評価の限界から解説します。
Xでシェア目次
- DLRMから行動sequenceへ何を変えたのか
- Rankingとretrievalを同じsequential transductionで表す
- HSTUはTransformerと何が違うのか
- 1. U、V、Q、Kは同じ入力を見る4つの役割
- 2. QKᵀで「どの履歴を見るか」を決める
- 3. Uでcontextをgateし、次のlayerへ渡す
- 具体例:シューズ候補をrankingする場合
- 長い履歴を現実の計算量へ収める4つの工夫
- 1. 長さの異なるsequenceをpaddingせず処理する
- 2. Stochastic Lengthで学習時の履歴を間引く
- 3. Activationとembedding optimizerのmemoryを減らす
- 4. M-FALCONで候補間の履歴計算を共有する
- Public datasetではどこまで改善したか
- Production評価の12.4%をどう読むか
- Recommendationにもscaling lawは現れたのか
- 公開実装で試せる範囲
- 導入するなら何を分けて検証するか
- Limitation
- まとめ
- 参照
AI利用の明示
本記事の構成と本文は、OpenAIのコーディングエージェント「Codex」が作成しました。数値と手法は原論文と公開実装を確認して記載していますが、利用時は原文も確認してください。
大規模な推薦システムは、ユーザーID、商品ID、属性、集計値などを人手で設計したfeatureへ変換し、複数のnetworkで組み合わせるDLRM(Deep Learning Recommendation Model)を長く使ってきました。MetaのJiaqi Zhaiらによる「Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations」は、この構成をユーザーの行動列を処理するGenerative Recommender(GR)へ置き換え、そのためのencoder HSTU(Hierarchical Sequential Transduction Unit)を提案したICML 2024論文です。対象はarXiv v3(2024年5月6日改訂)です。
この論文の価値は、推薦のrankingとretrievalをsequential transductionとして統一し、学習と推論の重複計算を減らす仕組みまで含めて、1.5兆parameterのmodelをproductionへ展開した点にあります。一方、「生成推薦」という名前からLLMが説明文や商品IDのtoken列を生成する手法を想像すると、論文の中心を取り違えます。
DLRMから行動sequenceへ何を変えたのか
従来の産業向けDLRMは、数値featureとカテゴリfeatureを別々に処理し、embedding、feature interaction、multi-task headなどを組み合わせます。新しいfeatureを加えるたびに、集計方法、保存、学習時の結合、serving時の整合性を管理する必要があります。
GRは、この異種featureを時間順のtoken列へまとめます。
従来のDLRM
  user/item ID + 集計値 + 属性 + cross feature
    → 個別のembedding・network
    → feature interaction
    → ranking / retrieval

Generative Recommender
  content Φ0, action a0, content Φ1, action a1, ...
    + 時間変化の遅いカテゴリfeature
    → 統合された時系列
    → HSTU
    → ranking / retrieval
主系列には、ユーザーが接触したcontentと、その後のlike、skip、視聴完了、shareなどのactionを置きます。言語や居住地、follow中のcreatorのように変化が遅いカテゴリfeatureは、同じ値が連続する区間を圧縮して主系列へmergeします。
CTRや回数のような数値featureはinteractionごとに変わるため、すべてをtoken化するとstorageと計算量が膨らみます。論文は、集計元となるカテゴリ情報が既にsequenceへ入っているなら、十分に表現力のあるtarget-aware modelが必要な集計を学べるとして、数値featureをmodel側の表現へ置き換えます。有限の履歴とmodel容量で完全に同じ情報を復元できる保証ではなく、production実験で有効性を確かめた設計仮説です。
Rankingとretrievalを同じsequential transductionで表す
入力token列を x0, x1, ...、各位置に対応する出力を y0, y1, ... とすると、論文は2つのtaskを次のように表します。
| Task | 入力 | 予測するもの |
|---|---|---|
| ranking | contentとactionを交互に並べた列 | 各contentに対する次のaction |
| retrieval | contentとactionを対にした履歴 | positive actionにつながる次のcontent |
rankingでは、候補contentを履歴の末尾へ置き、その候補に対するaction確率を予測します。これにより、候補と過去の履歴を早い段階で相互作用させるtarget-awareな処理になります。実運用では、content位置の出力を小さなnetworkへ通し、複数taskの予測へ変換します。
retrievalでは、履歴から次にpositive actionを得るcontentの分布を学びます。ただし、TIGERのように短いSemantic IDを自己回帰生成する方式とは異なり、この論文のfeature空間には大規模なatomic IDが残ります。著者らはretrieval時にMIPS、beam search、階層的retrievalなどを利用できるとしています。
ここでいう「generative」のもう1つの意味は学習例の作り方です。従来のimpression単位の学習では、同じユーザー履歴をtargetごとに何度もencoderへ通します。GRは1本のsequenceから複数位置のlossをまとめて計算し、encoderの仕事を複数targetで共有します。論文の解析では、ユーザーsequence長に反比例する割合でsampleすることで、全体の学習計算量を長さ N に対して1段階減らせます。論文Section 2
HSTUはTransformerと何が違うのか
HSTUは、同じlayerをresidual connectionで積み重ねるcausalなsequence encoderです。論文のFigure 3は、左に従来のDLRM、右に3層だけ描いたHSTUを並べています。左側ではfeature extraction、feature interaction、表現変換を別々のmoduleが担当します。右側では、同じHSTU layerを繰り返して3つの役割をまとめます。
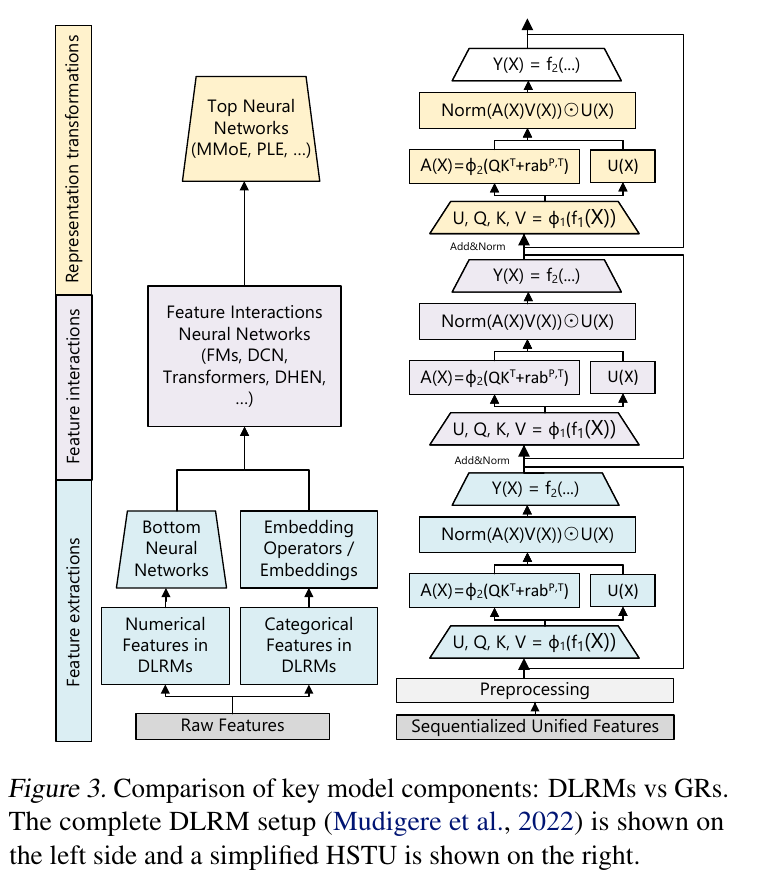
出典:Jiaqi Zhai et al., Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations, Figure 3。原図からFigure 3を切り出して掲載。画像部分はCC BY-NC-SA 4.0です。
1 layerの処理を先に一本のflowへすると、次のようになります。
入力 X(N個のtoken × d次元)
  ↓ 1つのlinear projection + SiLU
大きなtensorを U, V, Q, K に分割
  ↓
QKᵀ + 位置・時間bias → SiLU → attention weight A
  ↓
A × V → 履歴から集めたcontext
  ↓
LayerNorm(context) ⊙ U → f₂でd次元へ戻す
  ↓
元の入力をresidual connectionで加えて次のlayerへ
ここで X は、長さ N のsequenceを d 次元vectorで表した行列です。1行が「ある時刻に表示されたcontent」「そのときのaction」「途中へmergeした属性」など、1 tokenに対応します。HSTU layerは、各tokenが過去のどのtokenを参照し、何を受け取り、その情報を出力のどの成分へ通すかを計算します。
1. U、V、Q、Kは同じ入力を見る4つの役割
最初に X をlearnableなlinear layer f₁へ通し、SiLUを適用します。その大きな出力tensorを4つに分割したものが U、V、Q、Kです。「同じvectorを4個copyする」のではなく、学習された異なる重みにより、同じ入力から役割別の表現を一度に作ります。
| 記号 | 役割 | 直感的な読み方 |
|---|---|---|
Q(query) |
現在位置が過去から探したい情報を表す | 「この候補を判断するため、何を知りたいか」 |
K(key) |
各履歴tokenが何に関係するかを表す | 「この履歴は何についての情報か」 |
V(value) |
選ばれた履歴から実際に運ぶ内容を表す | 「参照されたとき、何を渡すか」 |
U(gate) |
集めた情報を出力の成分ごとに通す量を決める | 「この位置では、どの情報を効かせるか」 |
Q、K、VはTransformerとほぼ同じ役割です。UはHSTUの特徴で、attention後の出力を制御するgateです。論文のshapeでは、QとKは h × N × d_qk、UとVは h × N × d_vです。hはattention head数で、複数の観点から同じsequenceを見るための軸です。
4種類を別々のlayerで順番に計算するのではなく、f₁(X)という1回の大きなprojectionにまとめてからsplitするのは、GPU上で計算をbatch化・fuseしやすくするためです。
2. QKᵀで「どの履歴を見るか」を決める
現在位置 i のquery Qᵢと、履歴位置 j のkey Kⱼのdot productを取ると、両者の関連度を表すscoreが得られます。そこへ、sequence上の距離と実時間の差を表すrelative attention biasを足します。
score(i, j) = Qᵢ · Kⱼ + position_bias(i, j) + time_bias(i, j)たとえば同じ「ランニングシューズを見た」という行動でも、5分前と半年前では次の推薦への効き方を変えられます。sequence上で何token離れているかだけでなく、実際の経過時間もbiasに入れるのが推薦向けの設計です。causal maskがあるため、位置 i から未来のtokenは見えません。ranking候補を履歴の末尾へ置けば、その候補は自分より前の行動だけを参照できます。
通常のTransformerは、各queryについてscoreをsoftmaxへ通し、履歴全体のweight合計を1にします。HSTUは代わりに各scoreへSiLUを個別適用します。
Aᵢⱼ = SiLU(score(i, j))
contextᵢ = Σⱼ Aᵢⱼ Vⱼ
したがって Aᵢⱼ は合計1の確率ではありません。あるtopicに関係する履歴が増えれば、対応するvalueが複数回足し合わされます。softmaxは「10件の中でどれが最重要か」を表しやすい一方、1件しかない人と100件ある人でもweight総和は1です。HSTUがpointwise aggregationを使う狙いは、推薦で重要な興味の相対順位だけでなく、関連行動がどれだけ蓄積したかという強度も残すことです。
この仕組みはscoreの規模がsequence長や履歴内容によって変わりやすいため、A × Vでcontextを作った後にLayerNormを入れて学習を安定させます。論文では、このLayerNormがpointwise pooling後に必要だとしています。
3. Uでcontextをgateし、次のlayerへ渡す
履歴から得たcontextをnormalizeした後、同じ位置の Uと要素ごとに掛けます。
Zᵢ = LayerNorm(contextᵢ) ⊙ Uᵢ
Yᵢ = f₂(Zᵢ)⊙はvectorの要素ごとの積です。Uᵢは履歴tokenを選ぶweightではなく、集約済みcontextの各channelを開閉するgateです。たとえばcontextに「ブランド」「価格帯」「カテゴリ」「直近性」に対応する成分があるなら、現在の候補やuser stateに応じて、必要な成分を強く通し、不要な成分を弱めるイメージです。これは厳密に各channelが人間の概念へ対応するという意味ではなく、gateの働きを理解するための比喩です。
最後に f₂がmulti-headの出力をmodel次元 dへ戻します。通常のTransformerはattentionの後に大きなfeed-forward networkを持ちますが、HSTUは Uによるgateと f₂で表現変換を担い、独立したfeed-forward blockを使いません。論文は LayerNorm(A × V) ⊙ UをSwiGLUのvariantとして解釈でき、従来DLRMのMixture of Expertsに近い条件付き計算も要素積で表現できると説明しています。
Figure 3のAdd&Normはresidual connectionです。layerが作った Y(X)だけで入力を上書きせず、元の Xを足してnormalizeしてから次のlayerへ渡します。これにより、元のtoken情報を残しながら、layerを重ねるごとにより長い履歴とのinteractionを追加できます。
具体例:シューズ候補をrankingする場合
ユーザー履歴の末尾へ「新しいランニングシューズ」という候補を置いた場合を考えます。
- 候補位置の
Qが「この候補と関係する過去のsignal」を探す。 - 過去のシューズ閲覧、スポーツ用品購入、skipなどの
Kとの関連度を計算する。 - 位置・時間biasにより、直近の行動と古い行動の効き方を調整する。
- 関連度を使って、それぞれの履歴が持つ
Vを足し合わせる。 - 候補位置の
Uが、集めたcontextのうち今回の予測へ通す成分を調整する。 f₂とresidual connectionを経て、次のHSTU layerまたは予測headへ渡す。
この処理を複数layerで繰り返すことで、「この候補と直前の1行動」の関係だけでなく、複数の行動や属性を組み合わせたpatternを表現します。
通常のTransformerと比べた中核的な違いは、attention weightをsequence全体のsoftmaxで正規化せず、SiLUを使ったpointwise aggregated attentionにしたことです。位置と経過時間をrelative attention biasへ含めるため、順序だけでなく時間間隔も扱えます。
非定常なvocabularyを模したsynthetic streaming dataでは、HR@10が標準Transformerの 0.0442、softmax版HSTUの 0.0617、pointwise版HSTUの 0.0893でした。pointwise版はsoftmax版より44.7%の相対改善ですが、これは合成data上のablationであり、production全体における単独効果ではありません。論文Table 2
長い履歴を現実の計算量へ収める4つの工夫
HSTU layerだけでは、最大8,192 tokenの履歴、巨大なID vocabulary、数千から数万のranking候補を処理できません。論文のsystemは複数の最適化を組み合わせています。
1. 長さの異なるsequenceをpaddingせず処理する
ユーザーごとの履歴長は大きく偏ります。HSTUのGPU kernelはraggedなsequenceをgrouped GEMMとして処理し、padding部分の計算を避けます。論文では、この実装だけで2〜5倍のthroughput向上を報告しています。
2. Stochastic Lengthで学習時の履歴を間引く
ユーザー行動には、短期と長期の両方で似た行動が繰り返されるという仮定があります。Stochastic Length(SL)は、長い履歴を一定確率でsubsequenceへ縮め、attention計算のsparsityを増やします。30日分の履歴を使うproduction相当の設定では、最大長4,096、α = 1.6のとき80.5%のsparsityになり、実際のsequenceは多くの場合776 tokenまで縮みました。適切な α では主要taskのNormalized Entropy(NE)の悪化が 0.002 未満だったと報告されています。
これはinference時に常に80%を捨てるという話ではなく、主に高コストなtrainingを安くするsamplingです。Appendixの比較では、同程度のsparsityを作るzero-shot/fine-tuningによる長さ外挿よりSLのNE悪化が小さかったものの、非公開dataに基づく結果です。論文Section 3.2とAppendix F
3. Activationとembedding optimizerのmemoryを減らす
推薦modelは大きなbatchを必要とするため、parameterだけでなくactivation memoryがbottleneckになります。論文の見積もりでは、HSTUはlinear layerの削減とoperator fusionにより1 layerあたりのactivation stateをTransformerの 33d から 14d へ減らし、2倍を超える深さを同じmemoryで扱えます。
一方、1.5兆parameterという規模を理解するには巨大なID embeddingを無視できません。論文は、100億語彙、512次元、fp32のAdamでembeddingとoptimizer stateだけで60TBになる例を示します。row-wise AdamWとoptimizer stateのDRAM配置により、HBM使用量を1要素あたり12 byteから2 byteへ減らしています。「1.5兆parameter」は、1.5兆個のdense Transformer weightを持つLLMと同じ構成ではありません。
4. M-FALCONで候補間の履歴計算を共有する
rankingでは、同じユーザー履歴に対して最大数万件の候補をscoreします。候補ごとに履歴全体を再計算すると、target-aware attentionの利点がそのままcostになります。
M-FALCON(Microbatched-Fast Attention Leveraging Cacheable OperatioNs)は、候補をmicrobatchへまとめ、attention maskとrelative biasを調整して履歴側の計算を共有します。さらにencoderのKV cacheをmicrobatch間で再利用します。候補数を m、microbatch内の候補数を bₘ、履歴長を n とすると、候補ごとのcross-attentionに相当する計算を O(bₘn²d) から O((n + bₘ)²d) へ変えます。bₘ が n より十分小さければ、支配項はほぼ O(n²d) です。論文Section 3.4
Public datasetではどこまで改善したか
公開評価はMovieLens-1M、MovieLens-20M、Amazon Reviews Booksで行われています。baselineは、sampled softmaxを使う強いSASRec recipeです。HSTUはSASRecとlayer数・head数などを揃え、HSTU-largeはlayer数を4倍、head数を2倍にしています。次の値はarXiv v3のTable 4です。
| Dataset | Model | HR@10 | NDCG@10 |
|---|---|---|---|
| ML-1M | SASRec | 0.2853 | 0.1603 |
| ML-1M | HSTU | 0.3097(+8.6%) | 0.1720(+7.3%) |
| ML-1M | HSTU-large | 0.3294(+15.5%) | 0.1893(+18.1%) |
| ML-20M | SASRec | 0.2906 | 0.1621 |
| ML-20M | HSTU | 0.3252(+11.9%) | 0.1878(+15.9%) |
| ML-20M | HSTU-large | 0.3567(+22.8%) | 0.2106(+30.0%) |
| Books | SASRec | 0.0292 | 0.0156 |
| Books | HSTU | 0.0404(+38.4%) | 0.0219(+40.6%) |
| Books | HSTU-large | 0.0469(+60.6%) | 0.0257(+65.8%) |
括弧内はSASRecに対する相対改善です。HSTUと同じ構成の比較でも全datasetで改善し、modelを大きくするとさらに伸びています。ただし、この評価はfull-shuffle・multi-epoch学習です。1回だけ時系列順に流すproductionのstreaming学習とは条件が異なり、この65.8%をそのままオンライン効果として読んではいけません。論文Table 4
Production評価の12.4%をどう読むか
産業規模のencoder比較では、1000億件のDLRM相当exampleを1 passで学習し、1 jobあたり64〜256基のNVIDIA H100を使っています。rankingはmain engagement task(E-Task)とmain consumption task(C-Task)のNE、retrievalはlog perplexityで比較しています。
end-to-end比較では、retrievalのGRを新しい候補sourceとして加えると、匿名化されたonline指標がE-Taskで +6.2%、C-Taskで +5.0%でした。主要なDLRM sourceをGRで置き換えた場合は、それぞれ +5.1%、+1.9%です。rankingではGRが +12.4%、+4.4%を記録しました。
論文がabstractで掲げる「online A/B testで12.4%改善」は、このうちrankingのE-Taskにおける最大値です。すべてのsurfaceや指標が12.4%改善したわけではありません。E-TaskとC-Taskの具体的定義、traffic量、実験期間、信頼区間は公開されていないため、別のserviceへ移したときの効果量は推定できません。
効率面では、8,192 token、d = 512、8 head、H100、bfloat16のencoder比較で、FlashAttention 2を使うTransformerに対してtraining最大15.2倍、inference最大5.6倍でした。end-to-endのproduction rankingでは、FLOPsが285倍のGRが、1,024候補で1.50倍、16,384候補で2.99倍のQPSを達成しています。この結果はHSTU単体ではなく、ragged kernel、M-FALCON、cachingを含むsystem全体の値です。論文Section 4.2–4.3
Recommendationにもscaling lawは現れたのか
著者らは、HSTUのlayer数、embedding次元、head数、sequence長、retrievalのnegative数などを変え、学習computeを約3桁の範囲で増やしました。DLRMは約2,000億parameter付近で性能が飽和した一方、GRは1.5兆parameterまで改善が続き、retrievalのHR@100/HR@500とrankingのNEがcomputeに対してpower lawに従ったと報告しています。
最大構成は、sequence長8,192、embedding次元1,024、HSTU 24 layerです。streaming学習なので、computeは365日分へ正規化してGPT-3やLLaMA 2の学習規模と比較されています。著者らは、言語modelと違ってsequence長を他のparameterと一緒に伸ばすことが特に重要だと述べています。
これは「推薦model一般の普遍的なscaling law」が確立したという意味ではありません。観測は1社の非公開data、非公開task、限られたcompute範囲に基づきます。DLRM baselineの正確なproduction設定も機密で、論文では高水準の構成だけが説明されています。再現可能なpublic datasetの表と、production scalingの主張はevidenceの強さを分けて読む必要があります。論文Figure 7とAppendix E
公開実装で試せる範囲
公式repositoryはApache-2.0で、MovieLensとAmazon Reviewsのpublic実験、HSTUのTriton/CUDA kernel、training・inference用のDLRM-v3などを公開しています。READMEの確認環境はUbuntu 22.04、CUDA 12.4、Python 3.10で、public datasetの多くは24GB以上のGPU memoryが目安です。
git clone https://github.com/meta-recsys/generative-recommenders.git
cd generative-recommenders
pip3 install -r requirements.txt
mkdir -p tmp
python3 preprocess_public_data.py
CUDA_VISIBLE_DEVICES=0 python3 main.py \
  --gin_config_file=configs/ml-1m/hstu-sampled-softmax-n128-large-final.gin \
  --master_port=12345
これはML-1Mなどの公開条件を試す手順であり、1.5兆parameterのproduction modelを再現するものではありません。production data、feature定義、A/B test設定、学習cluster、全serving stackは公開されていません。また、repositoryのREADMEが示す一部の再現値はarXiv v3のTable 4とわずかに異なります。比較するときはpaperの数字と現在のcodeを混ぜず、commit、config、data preprocessingを固定する必要があります。
導入するなら何を分けて検証するか
この論文を実務へ適用するときは、「HSTUへ置き換える」という1つの変更にまとめず、次の順で効果を切り分けると判断しやすくなります。
- 評価を固定する:時系列split、strongなsequential baseline、HR/NDCGに加え、latency、memory、QPSを測る。
- encoderだけ比較する:同じfeature、loss、negative sampling、model規模でSASRec/TransformerとHSTUを比べる。
- featureのsequence化を試す:人手集計featureを一度に消さず、raw actionだけのGRとの差をablationで測る。
- 学習最適化を分ける:ragged kernelとStochastic Lengthを別々に導入し、長い履歴での品質劣化を監視する。
- servingを検証する:候補数ごとにM-FALCONのmicrobatch、KV cache、tail latency、HBM/DRAM転送を測る。
- 小さいonline testから始める:offline指標だけでなく、主要指標、guardrail、長期的な満足度を確認する。
atomic IDを使うため、新規item、rare item、embedding tableの更新、削除要求への対応も必要です。sequenceへfeatureを統一すれば自動的にprivacyが改善するわけではありません。どの行動を保存するか、保存期間、access control、user consentを別途設計する必要があります。
Limitation
この研究を読むうえで重要な制約は次の通りです。
- public実験は3 datasetのoffline評価で、productionと異なるmulti-pass・full-shuffle条件である
- productionのtask、data、baseline詳細、A/B test期間、sample数、統計的不確実性が非公開である
- 12.4%は匿名化されたranking E-Taskの最大改善で、売上やCTRなど特定のbusiness metricではない
- 総parameter数には巨大なID embeddingも含まれ、同規模LLMとのparameter数だけの比較は誤解を招く
- HSTU encoderの高速化、M-FALCON、production infrastructureの効果がend-to-end結果では一体になっている
- 新しいcontentや急変する嗜好にatomic ID表現がどうgeneralizeするかは、公開結果だけでは十分に判断できない
論文のImpact Statementは、手作りfeatureの削減がprivacyや長期的なuser valueの改善につながる可能性を述べています。しかし、privacy指標や長期outcomeを直接評価した結果は示していません。ここは実証済みの効果ではなく、将来の方向性です。
まとめ
Generative Recommenderの本質は、既存の推薦systemへLLMを足すことではありません。異種feature、ranking、retrieval、学習例の作り方をユーザー行動のsequential transductionとして再設計し、computeを増やすと品質が伸びる土台を作ることです。
HSTUのpointwise attentionは行動の「相対的な重要度」だけでなく「蓄積量」を残し、Stochastic Lengthは長い履歴のtraining costを抑え、M-FALCONは候補間で同じ履歴計算を共有します。public datasetでの改善は再現可能な入口ですが、1.5兆parameter、12.4%のonline改善、285倍のFLOPsを扱うproduction結果は非公開条件への依存が大きく、system全体のcase studyとして読むのが適切です。
参照
- Jiaqi Zhai et al., Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations, ICML 2024, arXiv v3, 2024-05-06.
- Jiaqi Zhai et al., PDF全文, 26 pages.
- Meta RecSys, generative-recommenders, official implementation, Apache-2.0.